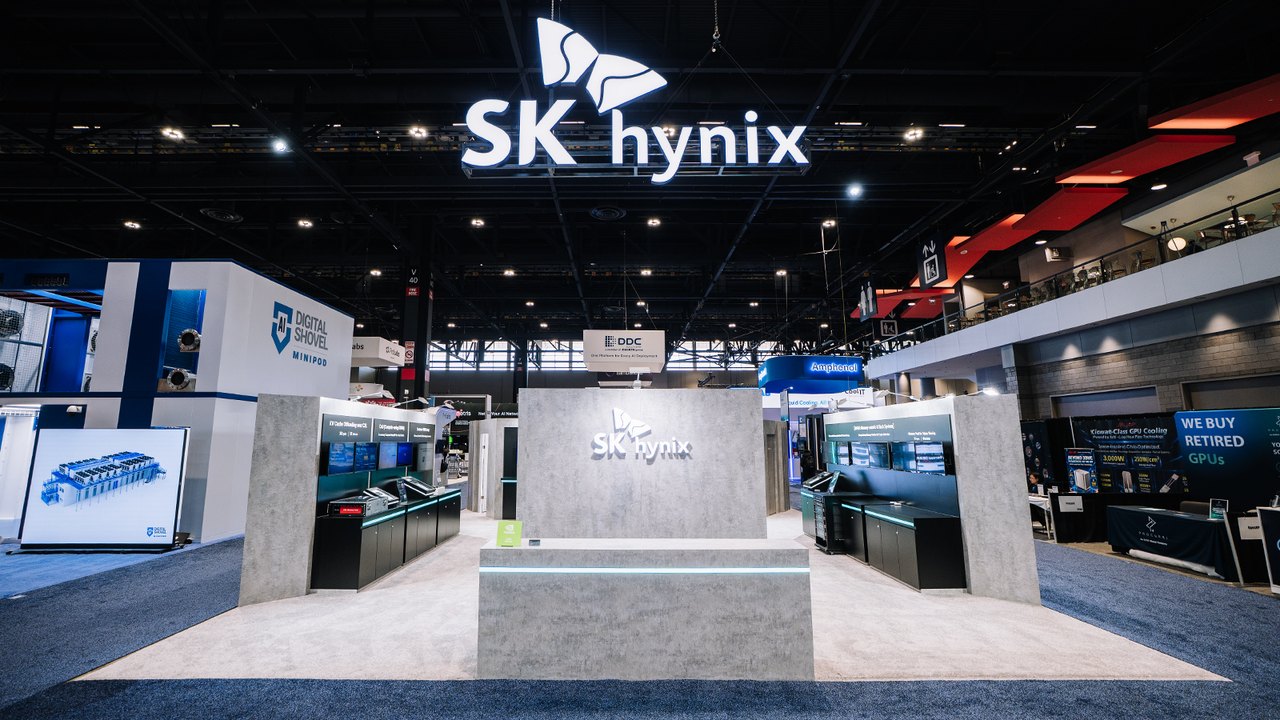
【DiaryPoint=オム・ジュヨン記者】SK hynixは11月20日、米シカゴで開かれたSupercomputing 2026で展示した技術を公開した。HBM4・HBM4EやCXLメモリプール、メモリを中心に据えたAIラックシステム「MARS」を披露し、対話型AIのデータ保存と再利用を効率化する方法を紹介した。
AIが長い会話を続けると、過去の計算結果を保持する「KVキャッシュ」が蓄積する。SK hynixは、すぐに再利用する可能性が高い情報をHBMやDRAMに置き、後で呼び出す情報をCXLメモリプールに保存する技術を展示した。保存先に応じてデータを振り分けることで、高速メモリの使用量を抑えながら複数のサーバーで容量を共有できるという。
MARSはメモリを中心に据え、協力企業の機器を1つのサーバーラックに統合するシステム構成だ。展示ではCXLメモリプールを使い、サーバーやGPU間でKVキャッシュを共有したほか、CPUサーバーが生成したトークンも共有した。重複計算を減らし、CPUの前処理によってGPUが待たされる時間を短縮する仕組みだ。
同社は、実際の大規模言語モデル(LLM)の推論環境で、SKテレコムとCXLを使ったKVキャッシュのオフロードを検証したと説明した。MARSについて発表したAIシステムインフラ技術リーダーのミン・ヨンフン氏は、CXLメモリプールによるキャッシュの再利用とCPUラック間のトークン共有によって、複数の対話型AIサービスでCPU・GPUの稼働率を高められると述べた。
展示製品には、HBM3Eと並んで展示されたHBM4・HBM4Eのほか、256GBの3DS DDR5 RDIMM、128GBのDDR5 MRDIMM、96GBのDDR5 RDIMM、192GBのSOCAMM2が含まれた。AI演算向けの広帯域メモリに加え、サーバーの主記憶装置やストレージにも需要が広がっていることを示す構成だ。
今回の技術は、主にAIデータセンターやサーバーでの活用を想定している。メモリの共有と再利用が実サービスに導入されれば、GPUの待ち時間やデータ移動の負担を減らせる可能性がある。メモリ容量や速度、電力効率をめぐる半導体メーカー間の競争も続きそうだ。Supercomputing 2026の展示期間は11月17日から19日までで、イベント全体は20日に終了した。