
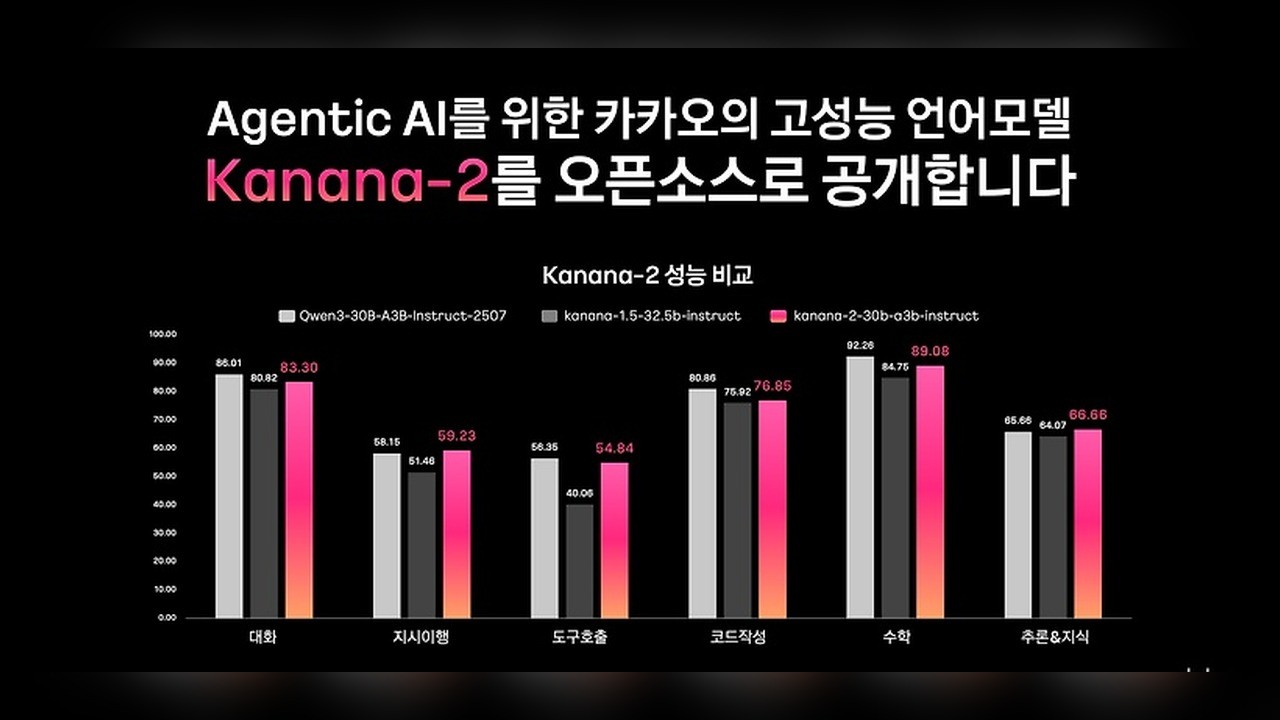
[다이어리포인트=엄주용 기자] 카카오가 대규모 인공지능(AI) 모델의 최적 학습률을 전체 학습비용의 약 1% 수준으로 예측하고, 모델 크기를 최대 40.4% 줄이는 연구 성과를 공개했다. 최적화 기술은 카카오의 카나나 모델 사전학습에 적용됐으며, 경량화 기술은 온디바이스 AI 환경에서 메모리 부담을 낮추는 데 활용될 가능성이 제시됐다.
카카오는 10월 8일 언어모델링 국제학회 ‘COLM 2026’에서 대규모 전문가 혼합(MoE) 모델의 학습 효율을 높이는 기술과 모델 경량화 연구 결과를 발표했다고 밝혔다. 이번 연구는 학회 메인 컨퍼런스와 토크나이제이션 워크숍 ‘TokShop’에서 각각 소개됐다.
메인 컨퍼런스에서 발표한 연구는 소규모 모델에서 찾은 최적 학습 설정을 대규모 모델로 확장하는 뮤 매개변수화 기법을 MoE 구조에 맞게 적용한 것이다. 모델 규모와 학습 토큰량을 단계적으로 늘리며 최적 학습률을 찾고, 짧은 학습 구간에서 얻은 설정이 대규모 학습에도 유효한지 검증하는 방식이다.
카카오는 이 방법을 ‘Kanana-2.6-155b-a17b’ 모델의 사전학습에 실제 적용해 10조 토큰까지 안정적으로 학습하는 데 활용했다고 설명했다. 학습률은 AI 모델이 학습 과정에서 내부 매개변수를 얼마나 크게 조정할지 정하는 값으로, 대규모 모델 개발의 안정성과 성능에 영향을 준다.
TokShop에서 공개한 ‘BBT(BPE-Guided Byte Transformer)’는 기존 단어, 단어 조각 중심의 토큰 처리 방식에 바이트 단위를 활용하는 구조를 더한 기술이다. 비교 실험에서 파라미터 수를 20.2~40.4% 줄였고 테스트 성능은 2.7~6.6% 개선됐다. 카카오는 오탈자나 문자 교란에 대한 강건성과 학습하지 않은 언어로의 전이 성능도 높아졌다고 밝혔다.
카카오는 BBT가 온디바이스 환경에서 AI 모델의 메모리 부담을 줄이고 다국어 입력이나 오탈자가 잦은 대화 환경에서 안정적인 성능을 구현하는 데 기여할 것으로 기대했다. 다만 이번 발표에서 구체적으로 상용화된 서비스 적용 일정이 제시된 것은 아니며, 카카오는 앞으로 다양한 모델 구조와 멀티모달, 다국어 환경으로 연구를 확장할 계획이라고 밝혔다.








0개의 댓글
최신순