
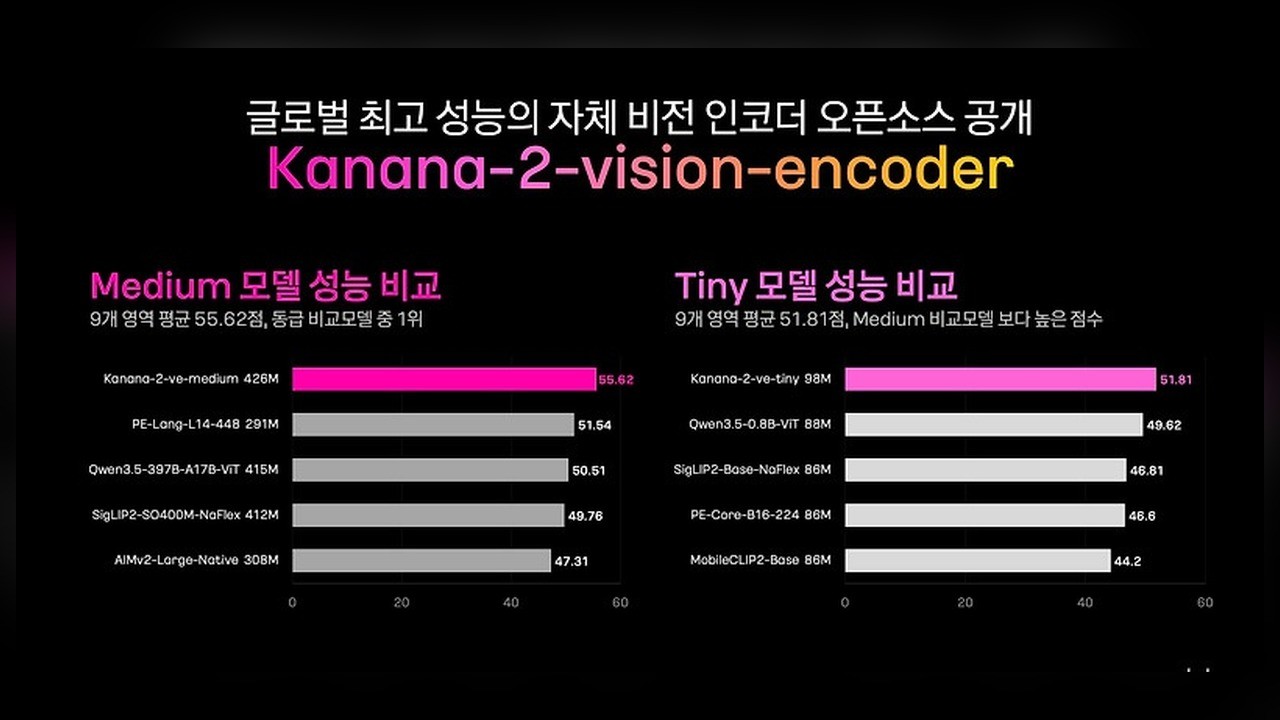
[다이어리포인트=엄주용 기자] 카카오가 이미지를 분석하는 인공지능 기술 ‘Kanana-2-vision-encoder’ 2종을 21일 오픈소스로 공개했다. 두 모델은 허깅페이스에서 연구개발과 서비스 제작에 활용할 수 있으며, 카카오는 상업적 이용도 가능한 ‘카나나 오픈 라이선스’를 적용했다.
공개된 모델은 4억2600만 파라미터 규모의 ‘medium’과 9800만 파라미터 규모의 ‘tiny’다. 비전 인코더는 이미지 속 사물과 글자, 위치, 형태 같은 시각 정보를 추출해 언어모델에 전달하는 기술이다. 언어모델은 이 정보를 이용자의 질문과 함께 해석해 이미지에 관한 답변을 만든다.
활용 분야는 메뉴판에 적힌 음식과 가격 읽기, 문서의 내용과 배치 파악, 사진 속 상황 설명 등이다. 이미지 기반 질의응답이나 문자 인식, 문서 이해, 이미지 안에서 특정 대상의 위치를 찾는 작업에도 사용할 수 있다.
카카오는 일반 시각 질의응답, 영어와 한국어 문자 인식 및 문서 이해, 이미지 내 위치 파악과 세밀한 인식 등 9개 영역의 42개 벤치마크로 성능을 평가했다고 밝혔다. 평가에서 두 모델은 구글의 ‘SigLIP 2’, 메타의 ‘Perception Encoder’, 애플의 ‘AIMv2’, 알리바바의 ‘Qwen3.5-ViT’ 등 주요 비전 인코더를 웃도는 성능을 기록했다는 설명이다.
특히 1억 개 미만 파라미터의 tiny 모델은 4억 개가 넘는 글로벌 모델과 비교해도 높은 성능을 보였다고 카카오는 밝혔다. 이미지 내 위치 파악과 한국어 시험, 한국어 문자 인식 및 문서 이해 영역에서 성능 차이가 컸으며, 작은 글자와 복잡한 문서 구조를 보존하는 학습 기술을 적용했다.
카카오는 자체 개발한 ‘Kanana-2’ 언어모델을 활용해 비전 인코더 학습 효율을 기존보다 약 4배 높였고, 글로벌 주요 비전 인코더보다 처리 지연 시간을 60% 이상 줄였다고 설명했다. medium 모델부터 온디바이스 활용을 고려한 tiny 모델까지 개발해 적용 환경에 따른 선택 폭도 넓혔다.
이번 공개는 카카오가 멀티모달 AI ‘Kanana-o’를 구성하는 기술을 외부에 제공하는 과정의 일부다. 카카오는 언어모델과 시각, 음성 처리 모듈 등 다른 구성 요소도 순차적으로 공개할 예정이라고 밝혔다.








0개의 댓글
최신순